Verticaliser un modèle d'IA : enrichir l'assistant avec les informations de l'entreprise
Denis PEYRUSAUBES
Un modèle de langage sait expliquer une procédure, résumer un document ou proposer une analyse. Pour travailler dans une entreprise, il lui manque pourtant l’essentiel : les informations qui font autorité chez elle, les outils qui donnent accès à ses données et les règles qui déterminent qui peut les consulter.
C’est ce que nous appelons ici verticaliser un modèle d’IA : construire autour de lui un système adapté à un métier. Dans notre approche, ses poids restent inchangés. Nous enrichissons le contexte qu’il reçoit et les capacités auxquelles il peut faire appel, grâce à la recherche documentaire, aux outils métier et aux consignes propres à l’organisation.
Nous avons construit ce système et décliné le même socle sur sept métiers. Le démonstrateur utilise principalement des corpus publics ; il permet d’éprouver l’architecture avant de la connecter à des informations d’entreprise. Voici ce que nous avons retenu, ce que les essais ont changé et ce qui reste à renforcer pour un usage sur des données confidentielles.
Partir des informations qui font autorité
La première question est souvent celle du modèle : « on prend GPT, Claude ou un modèle ouvert ? ». Le choix compte, notamment pour la qualité des réponses et la capacité à utiliser des outils. Il prend toutefois son sens après une autre question : sur quelles informations l’assistant doit-il fonder ses réponses ?
Pour une entreprise, ce peuvent être ses procédures qualité, sa documentation technique, ses contrats ou ses barèmes. Un même sujet peut être traité dans plusieurs documents, avec des dates et des périmètres différents. Retrouver un passage pertinent ne suffit donc pas : il faut savoir d’où il vient et s’il s’applique à la situation.
Trois contraintes orientent alors l’architecture.
La résidence des données détermine où peuvent être stockés les documents et traitées les questions. Ce périmètre dépend des exigences de l’organisation et des services choisis ; il doit couvrir toute la chaîne, y compris l’inférence.
La traçabilité permet de retrouver les sources consultées et les opérations réalisées. Elle aide à comprendre une réponse contestée et à identifier ce qui doit être corrigé dans le système.
La réversibilité permet de changer de modèle sans reconstruire le corpus ni les outils métier. Nous cherchons à conserver ces actifs tout en réévaluant la qualité des réponses à chaque changement.
Les grandes briques
L’identité s’appuie sur une authentification fédérée, destinée à être reliée à l’annuaire de l’entreprise. Les comptes et les habilitations doivent suivre son cycle de vie, avec une politique explicite de durée et de révocation des sessions.
La passerelle prend en charge l’entrée HTTPS et l’authentification. Le backend vérifie la signature du jeton d’identité et résout le métier demandé à partir du nom de domaine. Cette résolution et l’autorisation d’accès sont deux contrôles distincts.
L’agent conversationnel reçoit la question et choisit parmi les capacités mises à sa disposition : chercher dans les documents, interroger une source structurée, effectuer un calcul ou répondre directement.
Le modèle de langage interprète la demande et produit la réponse à partir de la conversation et des résultats des outils. Sa qualité reste déterminante, même lorsqu’il dispose de bonnes sources.
L’index documentaire rend les passages du corpus interrogeables. Notre recherche combine similarité vectorielle et recherche par mots-clés ; une recherche exacte complète le dispositif pour les références d’articles.
Une chaîne d’ingestion prépare cet index : elle lit les documents, les découpe et calcule leurs représentations vectorielles, les embeddings. Elle s’exécute en dehors du parcours d’une question. Nous conservons les sources et le processus de préparation pour pouvoir reconstruire l’index.
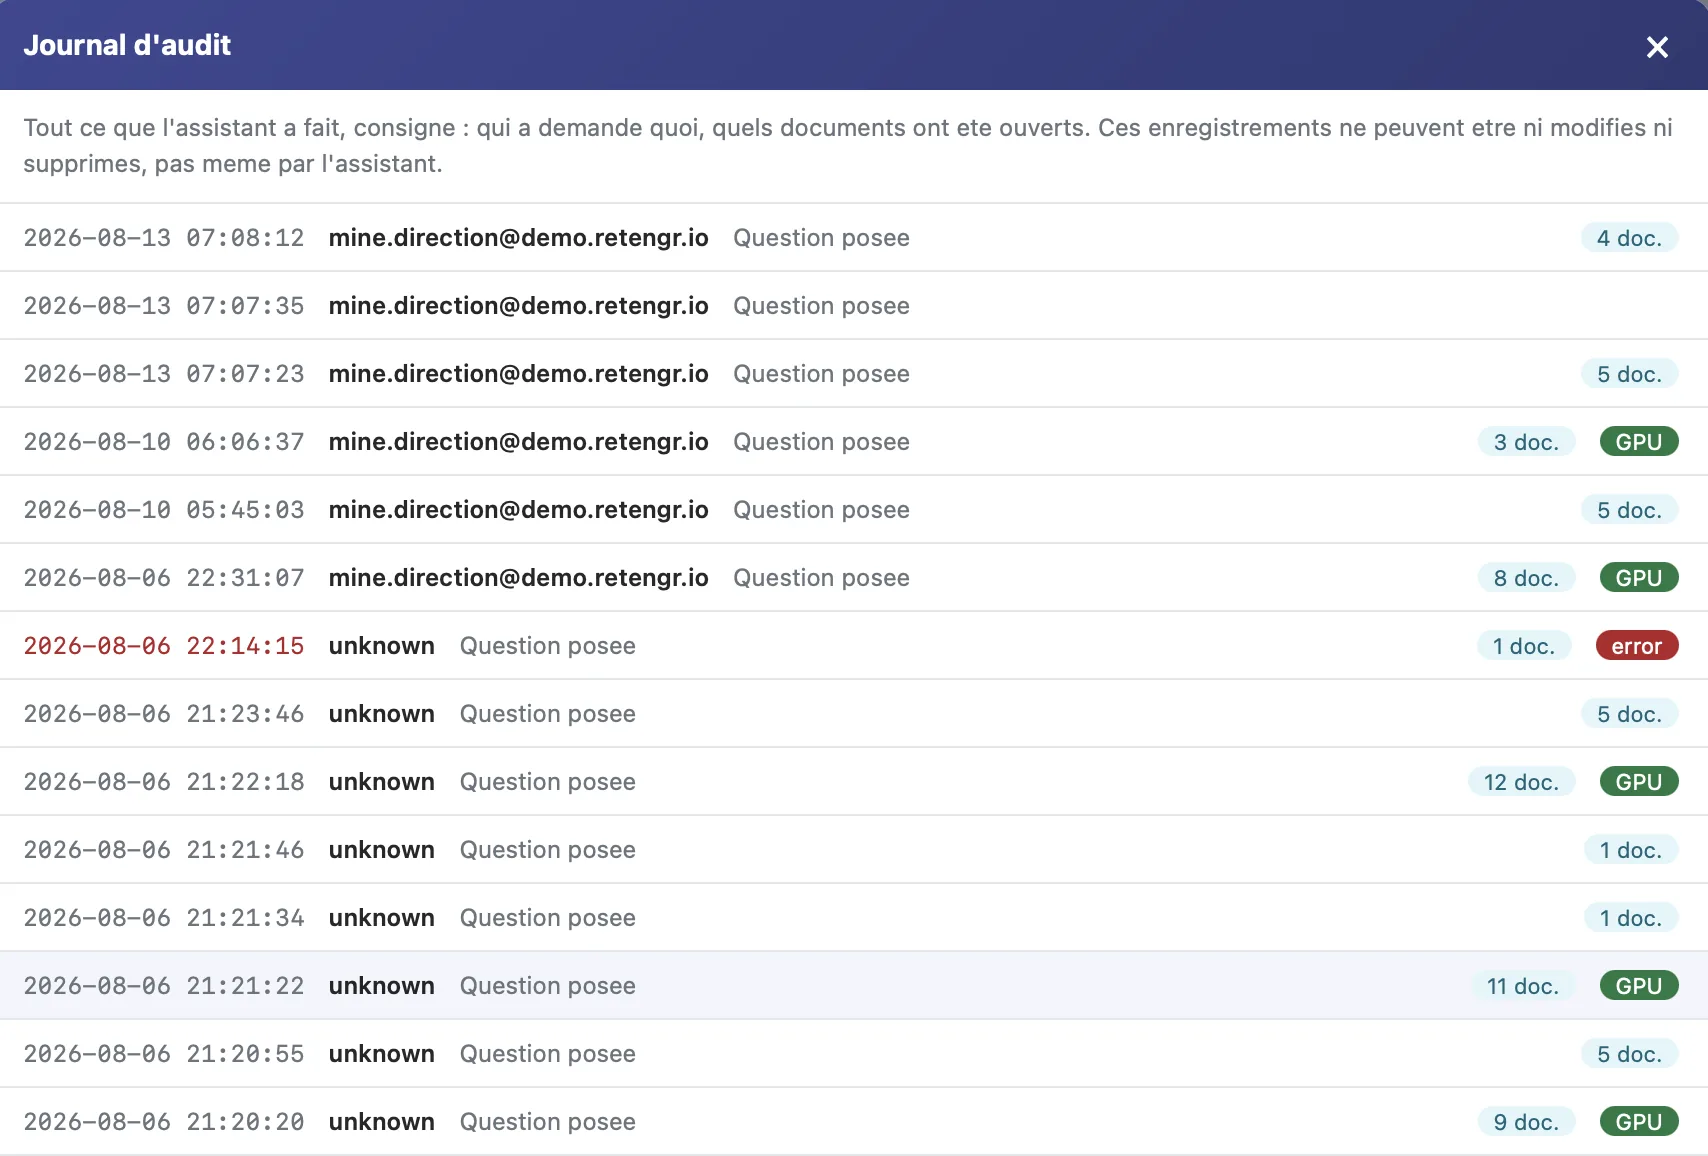
Les outils métier apportent les capacités qui demandent un calcul ou une requête précise. Le journal d’audit conserve des événements de consultation et d’opération, avec l’identité associée et les sources utilisées.
La verticalisation repose sur cet ensemble. Le prompt définit les consignes, le corpus apporte les références et les outils permettent de travailler avec les données du métier.
Prévoir la traçabilité dès le départ
Nous avons intégré l’audit tôt dans le projet. Cela oblige à décider ce qu’il faut pouvoir expliquer après une réponse : qui a posé la question, quelles sources ont été consultées et quelles opérations ont été effectuées.
Le journal utilise un bucket S3 avec Object Lock en mode gouvernance. Les versions enregistrées sont protégées pendant leur durée de rétention, et le rôle applicatif n’a pas le droit de les supprimer ni de contourner cette protection. Un administrateur disposant de permissions spécifiques conserve une possibilité de dérogation : c’est une caractéristique du mode gouvernance d’Object Lock.
Cette protection ne garantit pas, à elle seule, que tous les événements ont été collectés. La complétude du journal et la protection de ce qui est enregistré sont deux sujets différents. Le démonstrateur conserve notamment la question, les références consultées, des métriques et, selon sa taille, le plan d’exécution. Il ne constitue pas une transcription intégrale de chaque réponse.
L’identité vient du jeton signé, plutôt que d’un nom saisi dans la question. L’adresse réseau apporte un indice supplémentaire ; sa résolution en pays et opérateur se fait localement, sans l’envoyer à un service de géolocalisation. Elle reste indicative et ne remplace pas l’identité authentifiée.
Le journal et le corpus ont des stockages séparés. Ils n’ont ni les mêmes droits ni le même cycle de vie : un index se reconstruit, tandis qu’un événement d’audit doit rester consultable pendant la durée retenue. Cette séparation simplifie l’application de politiques adaptées à chacun.
Choisir un service de modèles tout en préparant son remplacement

Nous avons commencé avec Amazon Bedrock, qui s’intègre aux rôles IAM du compte AWS et donne accès à plusieurs familles de modèles. Cela nous a permis de construire et d’évaluer le parcours de l’assistant avant de brancher un serveur d’inférence auto-hébergé.
Le périmètre géographique doit être vérifié pour le modèle et le mode d’appel retenus. Le démonstrateur utilise un profil d’inférence européen : le traitement peut être réparti entre plusieurs régions de cette géographie. Choisir une région d’entrée ne suffit pas à garantir que toute l’inférence y reste. AWS distingue notamment l’inférence interrégionale géographique de l’inférence globale dans sa documentation Bedrock.
Dans le code, la création du modèle passe par une abstraction de fournisseur. Elle permet de connecter Bedrock ou un serveur compatible avec l’API attendue par l’agent, sans modifier les outils métier et le chargement du corpus.
Cette séparation réduit le travail nécessaire pour changer de fournisseur. Elle n’efface pas les différences entre modèles : formats, paramètres, fenêtres de contexte et fiabilité des appels d’outils doivent être vérifiés à chaque remplacement.
Changer de modèle au cours d’une conversation

Le démonstrateur propose un modèle servi par Bedrock et un modèle ouvert auto-hébergé. L’utilisateur peut choisir celui qui répondra à la question suivante. Cette bascule rend visible la réversibilité de la couche d’inférence.
Le registre vit dans un fichier de configuration de l’instance. Les secrets sont référencés par leur nom et résolus séparément. Le fichier est chargé puis mis en cache ; le choix de l’entrée du registre, lui, est effectué à chaque requête.
L’agent est reconstruit à chaque question avec l’historique de conversation. Cet historique est transmis en texte, sans dépendre des blocs d’appels d’outils propres à un fournisseur. Nous pouvons ainsi le réutiliser avec plusieurs modèles, au prix d’une restitution moins riche de certaines étapes internes.
Pour le serveur auto-hébergé, un contrôle de joignabilité permet de griser l’option lorsqu’il est arrêté. Ce contrôle améliore l’expérience, mais ne garantit ni la réussite de l’appel suivant ni la qualité de sa réponse.
Conserver la connaissance au-delà du modèle
Nous utilisons un modèle d’embeddings ouvert et multilingue, exécutable sur notre infrastructure ou chez le client. Le corpus peut ainsi être indexé sans dépendre d’un service d’embeddings propriétaire.
Changer de modèle de langage ne nécessite pas de reconstruire cet index. Changer de modèle d’embeddings, en revanche, impose de recalculer les vecteurs et de vérifier les résultats de recherche.
L’actif durable comprend donc les documents sources, leurs métadonnées et la chaîne d’ingestion, autant que l’index qui en résulte. La capacité à reconstruire et à évaluer cet ensemble donne une marge de choix sur l’hébergement et les fournisseurs.
Enrichir la réponse avec les documents de l’entreprise
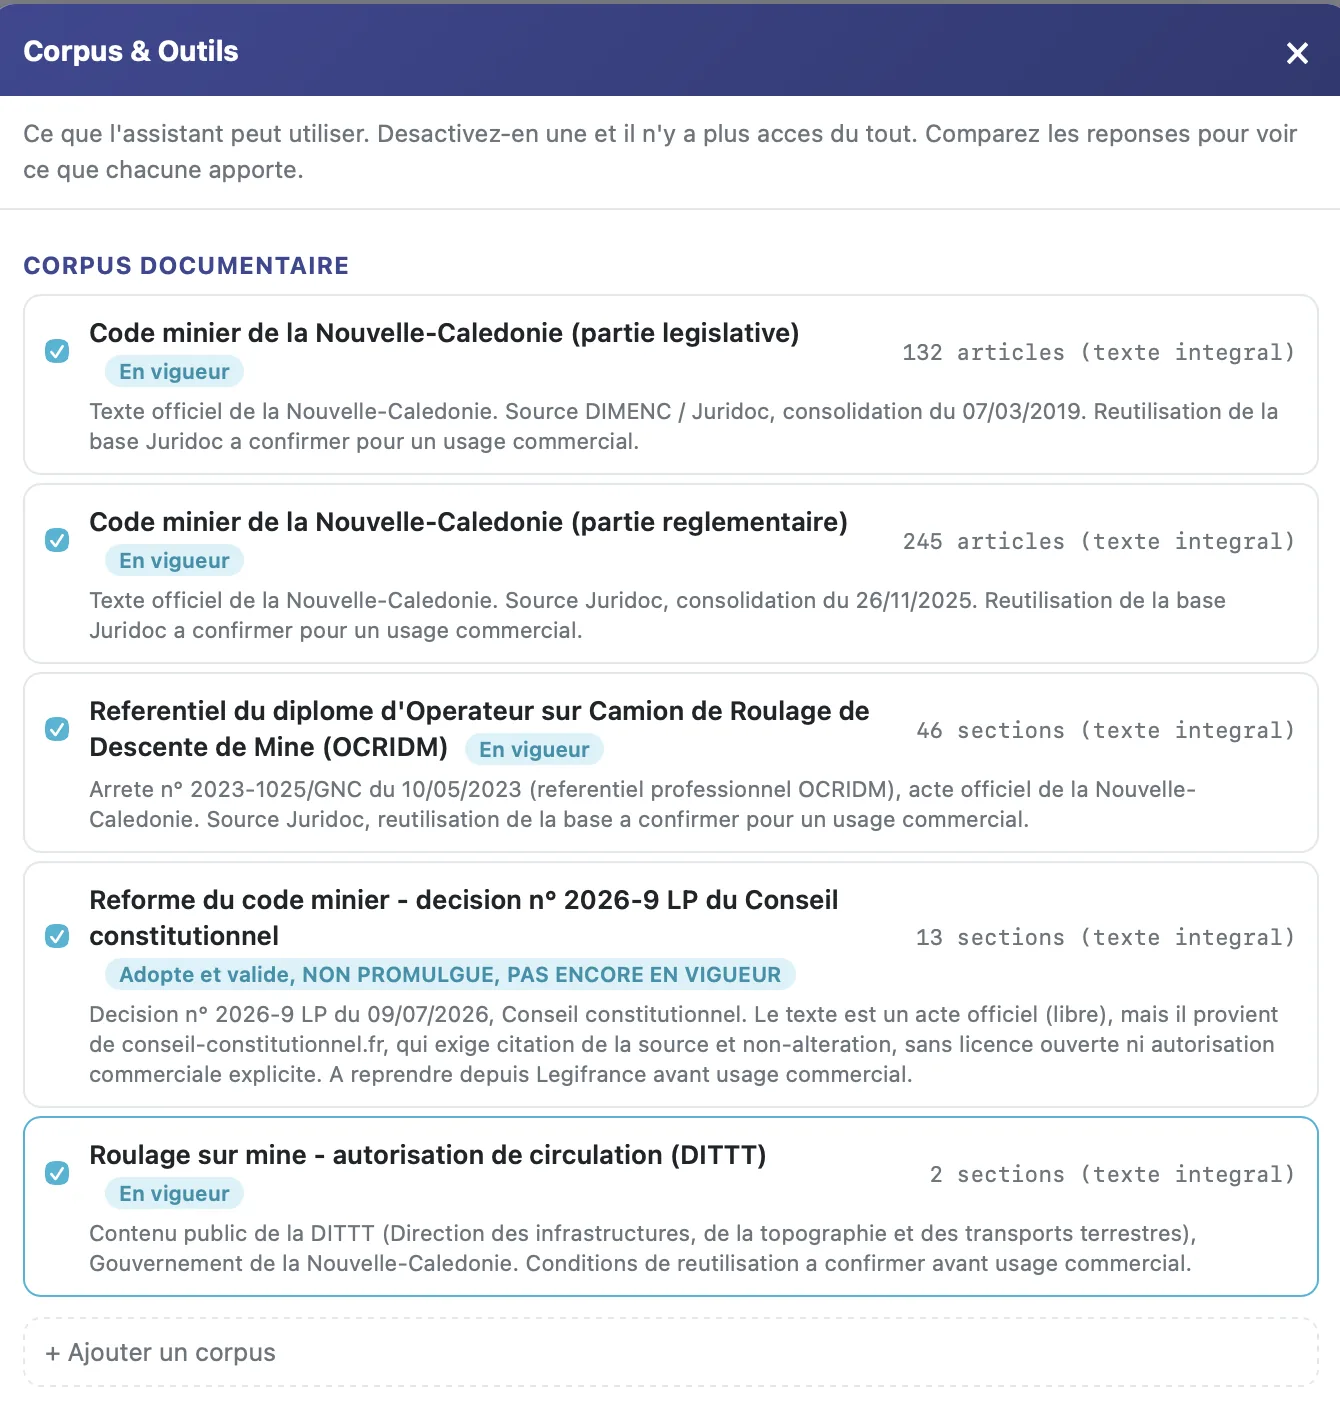
La recherche documentaire augmentée, ou RAG, fournit au modèle des passages utiles au moment de répondre. Elle ne modifie pas ses poids. Une procédure ajoutée au corpus devient exploitable après ingestion, sans entraîner à nouveau le modèle de langage.
Dans notre démonstrateur, elle répond à quatre besoins.
Citer une référence vérifiable. Le lecteur doit pouvoir ouvrir le texte utilisé et contrôler si la réponse en respecte le sens. Une citation présente n’est pas encore une preuve que l’interprétation est correcte.
Retrouver des informations spécifiques. Une procédure interne ou un rapport technique contient des détails que le modèle ne peut pas connaître de façon fiable à partir de son entraînement général.
Tenir compte des versions. La recherche peut apporter un texte récent, à condition que le corpus soit lui-même entretenu. Un index ancien reste une source ancienne, même derrière un modèle récent.
Comparer plusieurs modèles sur les mêmes références. Le corpus fournit une base commune ; l’évaluation permet de mesurer comment chaque modèle l’exploite.
Nous avons choisi une recherche déclenchée par l’agent. Cela évite de rechercher des documents pour chaque reformulation ou question de conversation. En contrepartie, il faut vérifier que le modèle appelle bien la recherche lorsqu’une réponse exige des sources.
La démonstration qui a révélé un manque de corpus
Lors d’une démonstration, une professionnelle du secteur a posé une question précise sur un texte réglementaire. L’assistant n’a pas pu répondre : le corpus ne contenait que quatre sources, dont deux guides pédagogiques.
Nous avons ensuite identifié un accès aux textes consolidés et enrichi le corpus jusqu’à dix-neuf sources, représentant plus de deux mille extraits. La question initiale est devenue un cas de vérification : retrouver la bonne réglementation, l’article applicable et les délais qu’il prévoit.
Cet épisode montre où commence le travail métier. La qualité du corpus se mesure aux questions auxquelles il doit permettre de répondre. Ajouter des documents sans examiner leur portée, leur version et leur couverture ne résout pas nécessairement le problème.
Évaluer aussi la décision de rechercher
Un autre défaut est apparu avec le modèle auto-hébergé. Lors d’essais consignés le 6 août 2026, une même question sur les droits attachés à une concession minière a produit deux comportements : une réponse déclarant l’information absente sans lancer de recherche, puis une réponse appuyée sur les articles retrouvés.
Le plan d’exécution a permis de localiser la différence : dans le premier cas, l’outil de recherche n’avait jamais été appelé. Modifier le découpage du corpus n’aurait pas corrigé cet échec.
Nous avons donc ajusté les consignes et les paramètres du modèle. Le suivi de ces comportements rejoint les pratiques abordées dans notre formation Observabilité : traces, métriques et diagnostic des incidents. Le projet comprend aussi un harnais d’évaluation qui rejoue le parcours de l’agent et examine la recherche, les appels d’outils, les réponses, leur latence et leur coût. Une comparaison n’a de sens qu’avec les versions de modèles, les prompts et le corpus utilisés ; ces ajustements doivent être réévalués avant de conclure à une amélioration durable.
Une interface qui aide à vérifier la réponse
Le front utilise React, une bibliothèque de conversation, Vite et une bibliothèque de cartographie. Le choix de ces composants compte pour la réalisation ; pour l’utilisateur, l’essentiel est ailleurs.
L’interface doit rendre visibles les sources, les opérations en cours et les limites du résultat. Une carte facilite la lecture d’une donnée géographique. Un export conserve les références de la réponse. Un indicateur d’activité évite de confondre une recherche longue avec une panne.
Les messages doivent rester compréhensibles. Une erreur de connexion doit indiquer quoi faire ; la protection du journal doit être décrite dans son périmètre réel. La simplicité du vocabulaire ne doit pas transformer une protection limitée en promesse absolue.
Décliner le système sur plusieurs métiers

Sept métiers sont configurés dans un même déploiement : mine, santé, énergie, environnement marin, tourisme, télécommunications et pêche. Chacun apporte son corpus, ses consignes et ses profils. Certains ajoutent des outils de calcul ou d’interrogation de données ; d’autres reposent principalement sur la recherche documentaire.
Le socle charge les éléments du métier actif, tandis que le modèle d’embeddings est partagé. Cette organisation permet d’ajouter un domaine sans dupliquer toute l’application.
Le nom de domaine sert à sélectionner le métier côté serveur. Il ne constitue pas une autorisation : le serveur doit aussi vérifier que l’identité authentifiée peut accéder au domaine et aux documents demandés.
Le filtrage documentaire utilise les rôles du contexte de requête, sans les laisser choisir par le modèle. Cette règle est importante : une instruction présente dans un document ne doit pas permettre à l’agent de s’attribuer des droits supplémentaires.
Ce qui relève d’un outil métier
Un document peut expliquer un barème. Pour appliquer ses tranches à une situation donnée, nous préférons un outil de calcul explicite, dont les entrées et les règles peuvent être vérifiées.
Le même principe vaut pour une base structurée : un outil peut compter des titres miniers ou interroger une donnée géographique sans demander au modèle de reconstruire le résultat à partir de passages de texte.
La fiabilité dépend toujours de la source, de sa mise à jour et du périmètre couvert par l’outil. Si un calcul reste une estimation ou si une liste est partielle, le résultat doit le signaler.
Ce que le démonstrateur ne garantit pas encore
Le démonstrateur permet de vérifier la déclinaison métier et le changement de modèle. Il ne constitue pas encore une preuve de cloisonnement pour des données confidentielles.
Des facilités de démonstration subsistent : un domaine inconnu peut revenir au premier métier configuré, et un utilisateur sans rôle métier bénéficie d’un accès élargi. Avant un déploiement client sur corpus restreint, ces comportements doivent devenir des refus explicites et être vérifiés avec plusieurs identités et niveaux d’accès.
L’audit demande également de tester les pannes de collecte et de stockage, ainsi que les droits de consultation du journal. Protéger les événements enregistrés ne garantit pas que chaque opération a laissé une trace complète.
Enfin, la souveraineté s’apprécie sur l’ensemble du système : inférence, documents, index, identité, journaux, sauvegardes et services externes. Le sélecteur de modèles démontre une capacité de remplacement. Les garanties d’un déploiement dépendent ensuite de ses choix d’hébergement, d’accès et d’exploitation.
Les choix techniques du démonstrateur, en détail
Le schéma ci-dessous rassemble la configuration relevée dans les dépôts au 7 septembre 2026 : ressources de calcul, moteurs de recherche, modèles et réglages. Il décrit le déploiement prévu par ces fichiers, sans constituer un inventaire en temps réel des machines allumées.
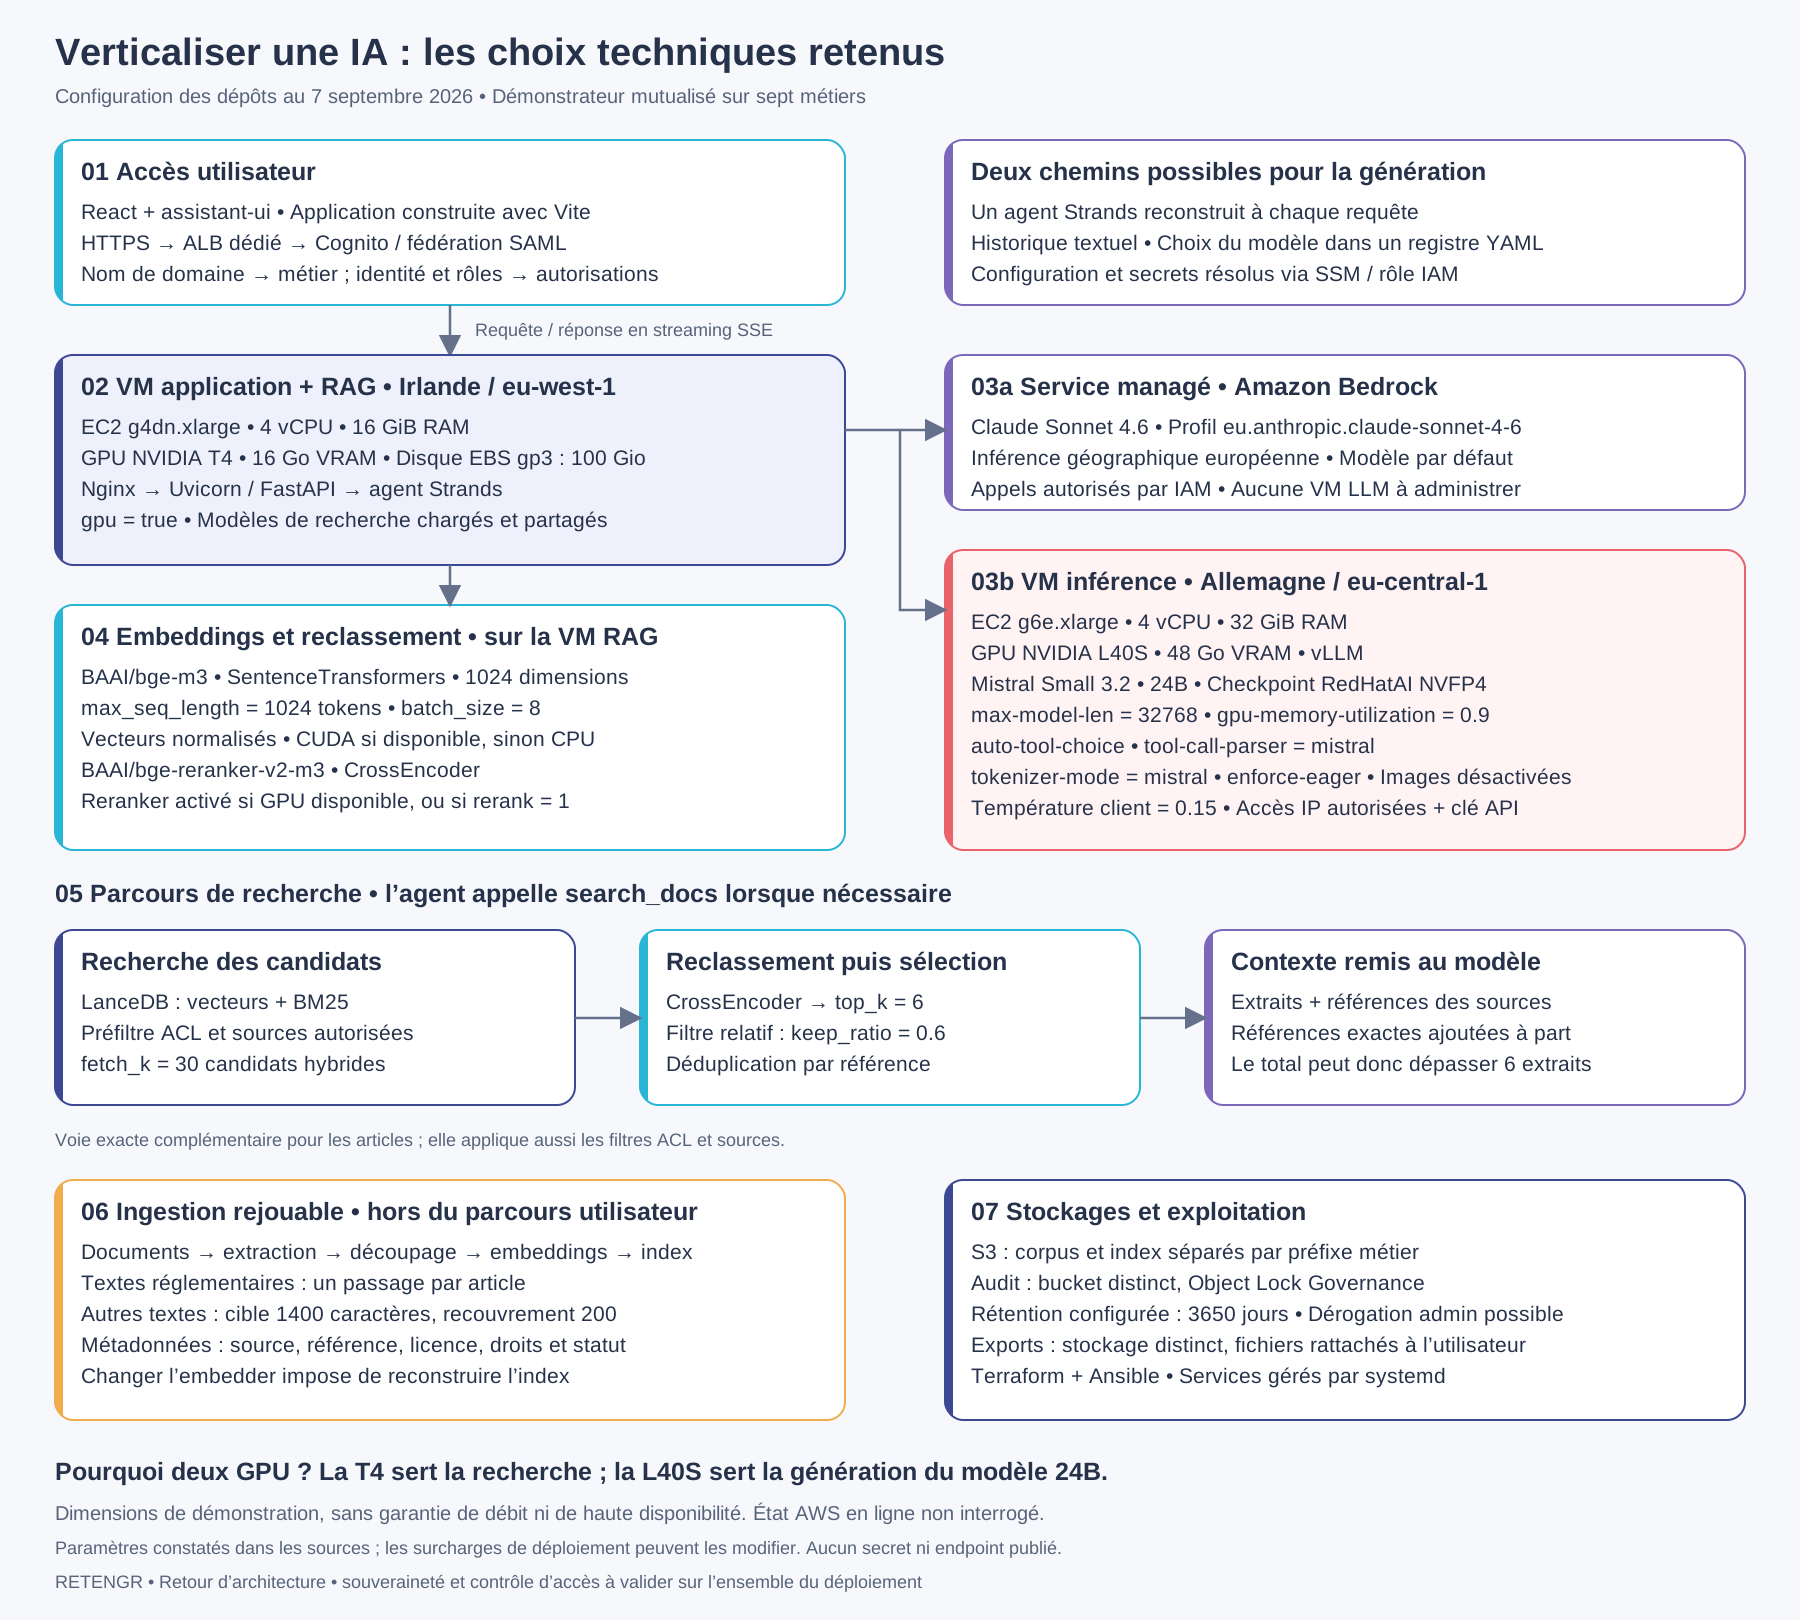
Deux VM remplissent des rôles différents. L’application et la recherche utilisent une g4dn.xlarge en Irlande : 4 vCPU, 16 GiB de RAM, un GPU T4 de 16 Go et un disque EBS gp3 de 100 Gio. Le serveur vLLM utilise une g6e.xlarge en Allemagne : 4 vCPU, 32 GiB de RAM et un GPU L40S de 48 Go. Ces caractéristiques des instances AWS expliquent la séparation : la première machine exécute les modèles de recherche, la seconde porte la génération avec un modèle de 24 milliards de paramètres. Il s’agit d’un dimensionnement de démonstration, à mesurer sous charge avant de le reprendre pour une entreprise.
Les embeddings sont calculés avec BAAI/bge-m3, via SentenceTransformers. Les vecteurs ont 1 024 dimensions et sont normalisés. La fenêtre d’encodage est réglée à 1 024 tokens, avec des lots de huit passages. Ce réglage limite le coût de calcul, mais demande de contrôler la longueur des passages : un texte plus long peut être tronqué lors de l’encodage. L’ingestion découpe les textes réglementaires par article ; pour les autres textes, elle vise des sections de 1 400 caractères avec un recouvrement de 200 caractères.
La recherche combine plusieurs étapes. LanceDB fournit 30 candidats par recherche hybride, vectorielle et lexicale BM25. Le cross-encoder BAAI/bge-reranker-v2-m3 les reclasse avant une sélection plafonnée à six candidats, avec un filtre relatif réglé à 0.6. Les références d’articles retrouvées par la voie exacte s’ajoutent séparément : le total fourni au modèle peut donc dépasser six extraits. Les filtres de droits et de sources s’appliquent aux deux voies. Le reclassement s’active automatiquement lorsqu’un GPU est disponible ; il peut aussi être demandé par configuration sur CPU.
Mistral est servi par vLLM avec une configuration propre au modèle. Le checkpoint retenu est RedHatAI/Mistral-Small-3.2-24B-Instruct-2506-NVFP4. La fenêtre de contexte du serveur est fixée à 32 768 tokens et la fraction de mémoire GPU à 0.9. Le choix automatique des outils est activé, avec le parseur et le tokenizer Mistral, un template de conversation adapté et le mode enforce-eager. Les images sont désactivées pour ce parcours textuel. Côté client, la température est fixée à 0.15 : ce paramètre fait partie des réglages à réévaluer avec les prompts et les appels d’outils.
L’exploitation reste explicite. Terraform décrit les ressources, Ansible prépare les machines et systemd lance les services. Nginx relaie les échanges vers FastAPI/Uvicorn ; Strands reconstruit l’agent à chaque requête. Les secrets sont résolus via SSM. Les corpus, le journal et les exports ont des politiques de stockage distinctes. La rétention du journal est configurée à 3 650 jours en mode gouvernance : c’est un choix du démonstrateur, à adapter aux besoins et aux obligations de chaque déploiement.
Le rendu final dans l’assistant
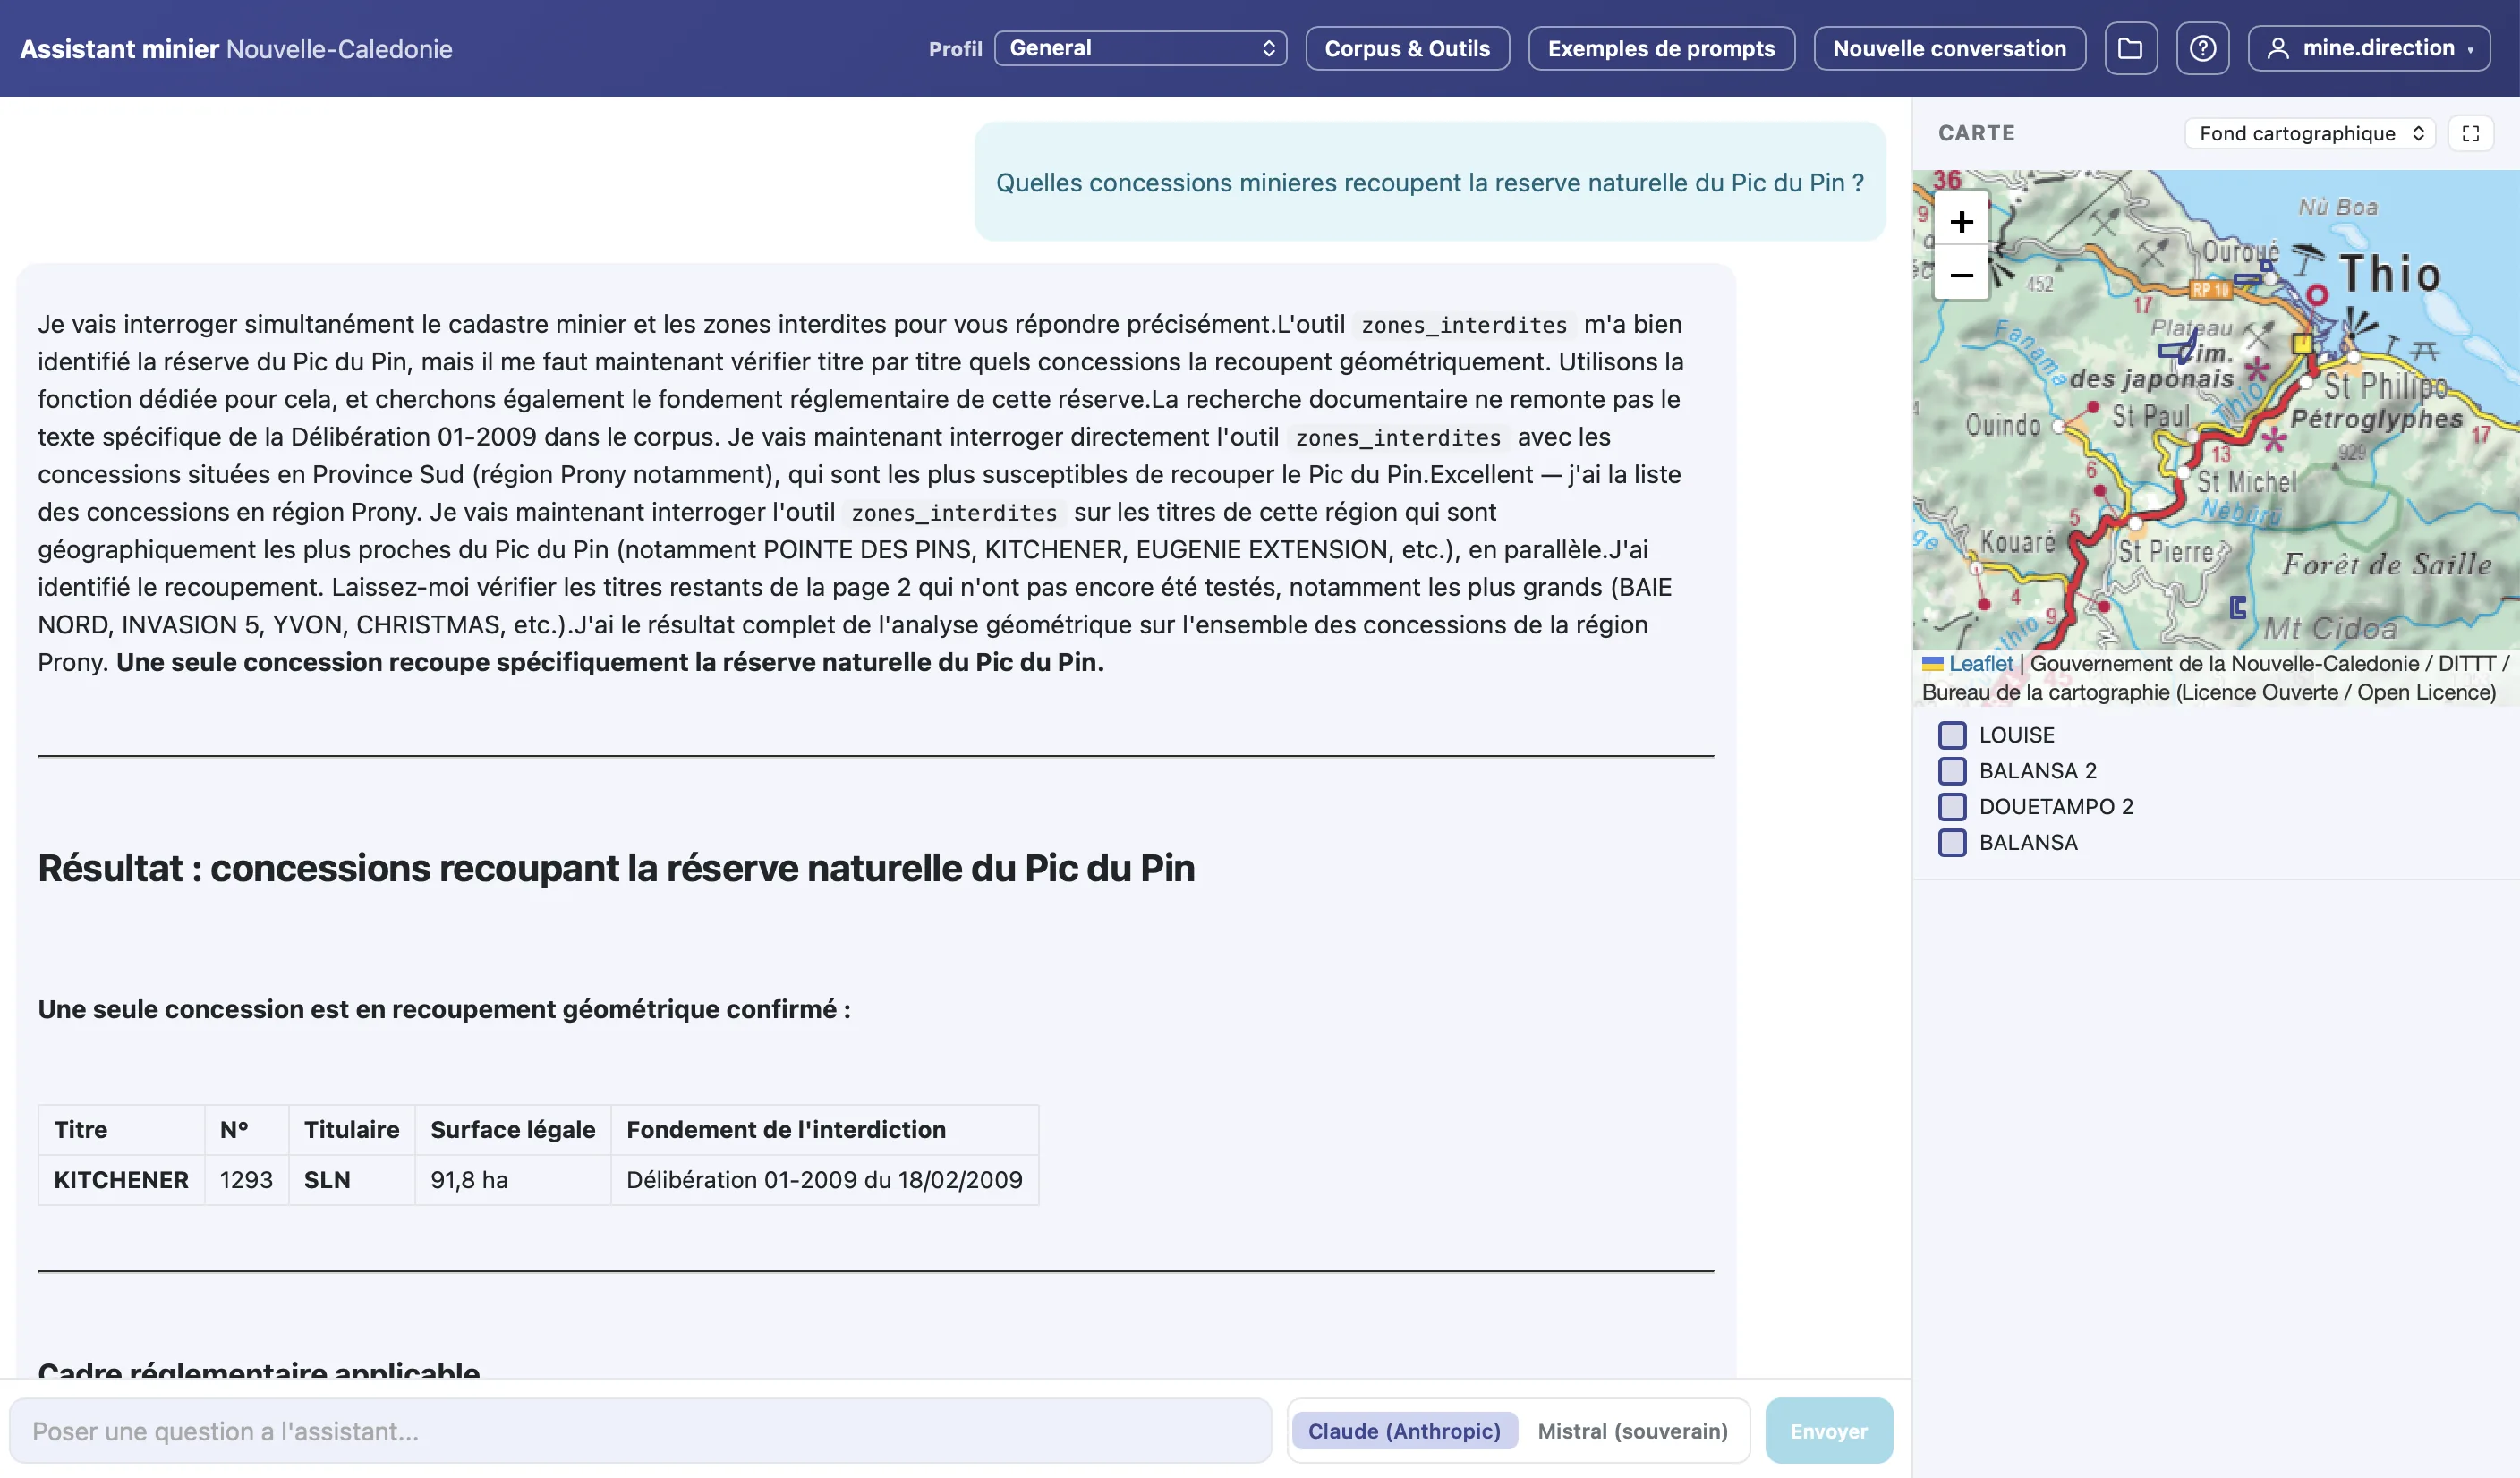
Ces vues montrent le parcours côté utilisateur : une réponse enrichie par les outils métier et la cartographie, la sélection des corpus, les documents produits par l’assistant et le journal d’audit. Cliquez sur une vignette pour l’ouvrir à sa taille réelle.
Ce que cette verticalisation apporte à l’entreprise
Un assistant métier se construit en reliant les capacités d’un modèle généraliste aux informations qui font autorité, aux outils qui exécutent les opérations utiles et aux droits des personnes qui l’utilisent.
Notre démonstrateur montre qu’un même socle peut servir plusieurs métiers et plusieurs modèles. Il montre aussi où se concentre le travail : préparer le corpus, vérifier les réponses sur des cas réels, contrôler les accès et rendre les opérations explicables.
Ces sujets sont au cœur de notre formation Fondations LLM/RAG vers Agents. Pour approfondir les architectures, la sécurité et la supervision, la formation Agents : mise en production et architectures avancées prolonge ce parcours. Vous pouvez aussi nous présenter votre contexte d’entreprise pour construire une formation adaptée à vos équipes.