Déléguer à sept agents IA sans perdre la main
Denis PEYRUSAUBES
Faire travailler plusieurs agents IA sans surveillance permanente demande surtout une organisation claire. La difficulté apparaît dès qu’un premier agent rend son résultat : celui-ci peut terminer une tâche, révéler un écart, demander un contrôle ou créer du travail pour un autre spécialiste. L’orchestrateur doit alors décider de la suite : accepter, faire corriger, déléguer, attendre une réponse humaine ou arrêter le processus.
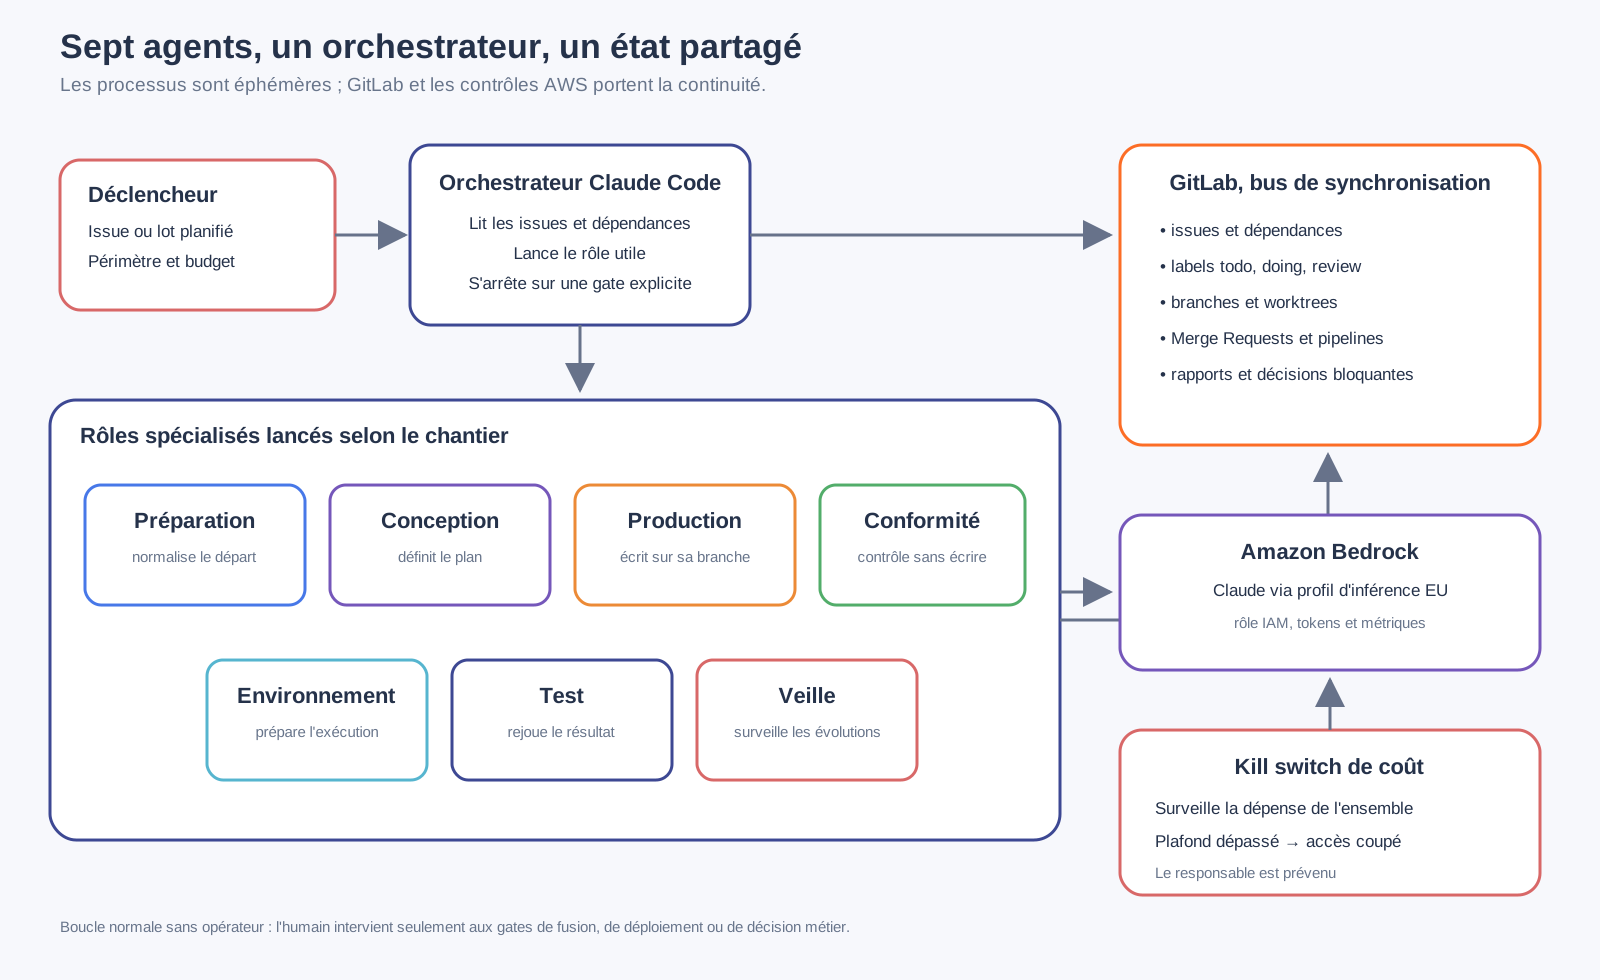
Dans notre architecture, GitLab est le point de centralisation de ces constats et de ces décisions. Les agents y déposent leurs résultats, leurs preuves et les tâches qui en découlent. L’orchestrateur relit cet état partagé avant chaque tour : le constat d’un agent peut ainsi devenir la commande donnée au suivant.
Une fois cette boucle de pilotage en place, il reste à l’exécuter et à en maîtriser le coût. Claude Code lance les sept agents spécialisés, Amazon Bedrock leur donne accès aux modèles Claude et un kill switch, autrement dit un coupe-circuit, arrête les appels si la dépense dépasse le plafond prévu.
La nature des livrables produits par les agents importe peu ici : cette architecture peut maintenir de la documentation, préparer des changements dans plusieurs dépôts ou conduire une chaîne d’analyse. Ce retour d’expérience porte sur le fonctionnement de la fabrique, pas sur ce qu’elle fabrique.
Sans interaction humaine ne veut pas dire sans contrôle
Le premier prototype utilisait des sessions interactives. Dès qu’un agent demandait une autorisation, le travail attendait dans un terminal. En mode headless, chaque tour lancé avec claude -p dispose d’un budget et d’un nombre maximal d’étapes, puis écrit son état dans GitLab.
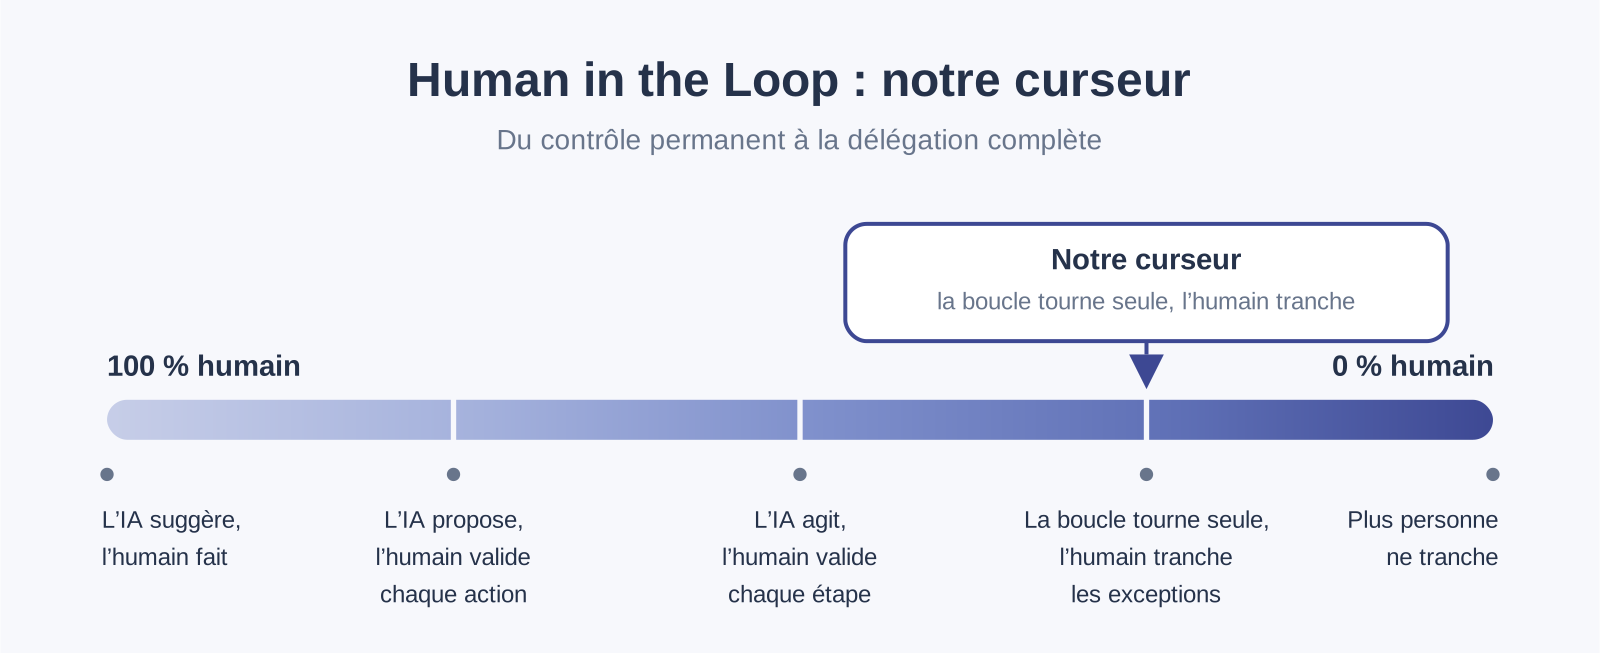
L’absence d’interaction humaine concerne la boucle normale : l’orchestrateur choisit la prochaine tâche, lance le bon spécialiste, constate son résultat et poursuit. Une décision irréversible ou métier reste toutefois un point d’arrêt explicite : fusion d’une Merge Request, déploiement, dépense d’infrastructure ou ambiguïté qui changerait le résultat. La gouvernance reste humaine ; les confirmations répétitives disparaissent.
Où l’humain entre dans la boucle
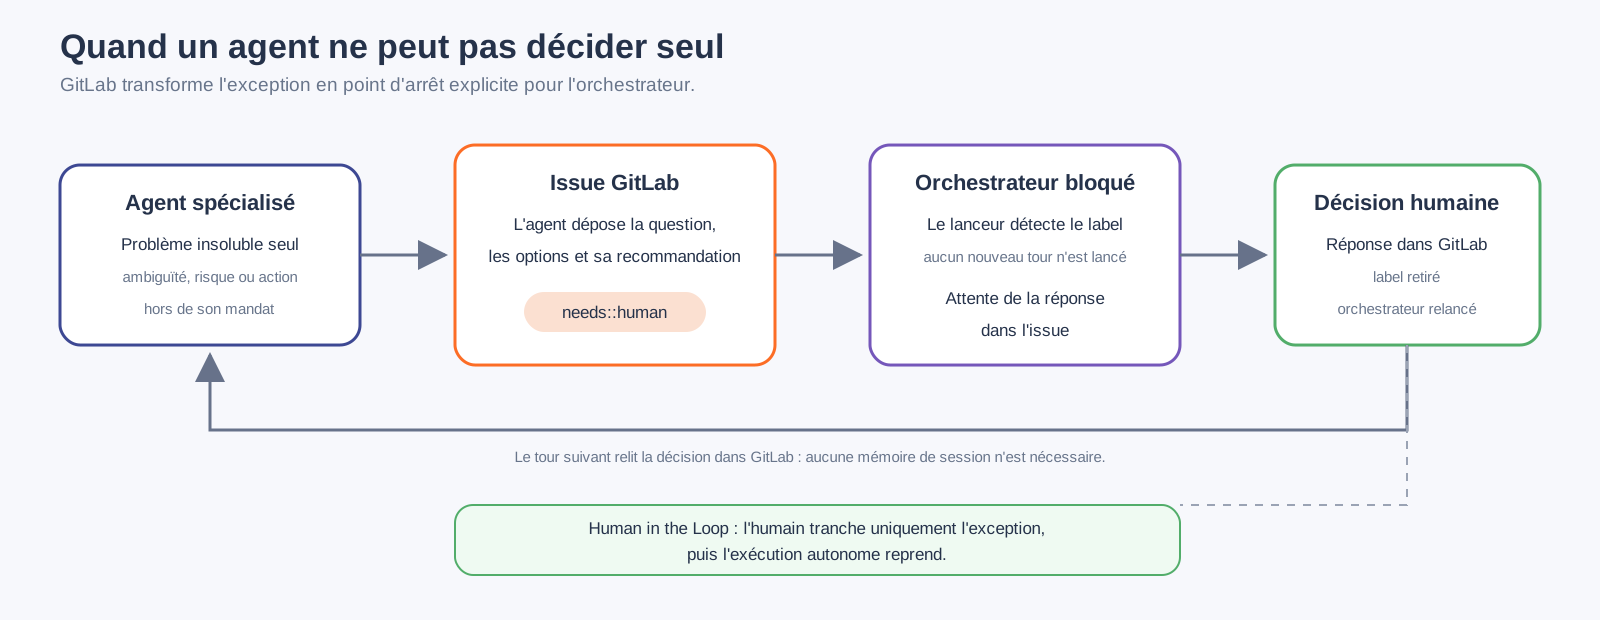
Lorsqu’un agent rencontre un problème qu’il estime ne pas pouvoir résoudre dans son mandat, il le consigne dans GitLab avec la question, les options déjà examinées et sa recommandation. L’issue reçoit le label needs::human. Le lanceur headless détecte ce label et l’orchestrateur se bloque au lieu d’improviser une décision.
L’humain répond directement dans l’issue. Une fois la décision enregistrée et le label retiré, le tour suivant relit GitLab et reprend le travail. C’est ici que se situe le Human in the Loop (HITL) : l’humain n’accompagne pas chaque action, mais il tranche les exceptions que les règles du système ont volontairement placées hors du pouvoir des agents.
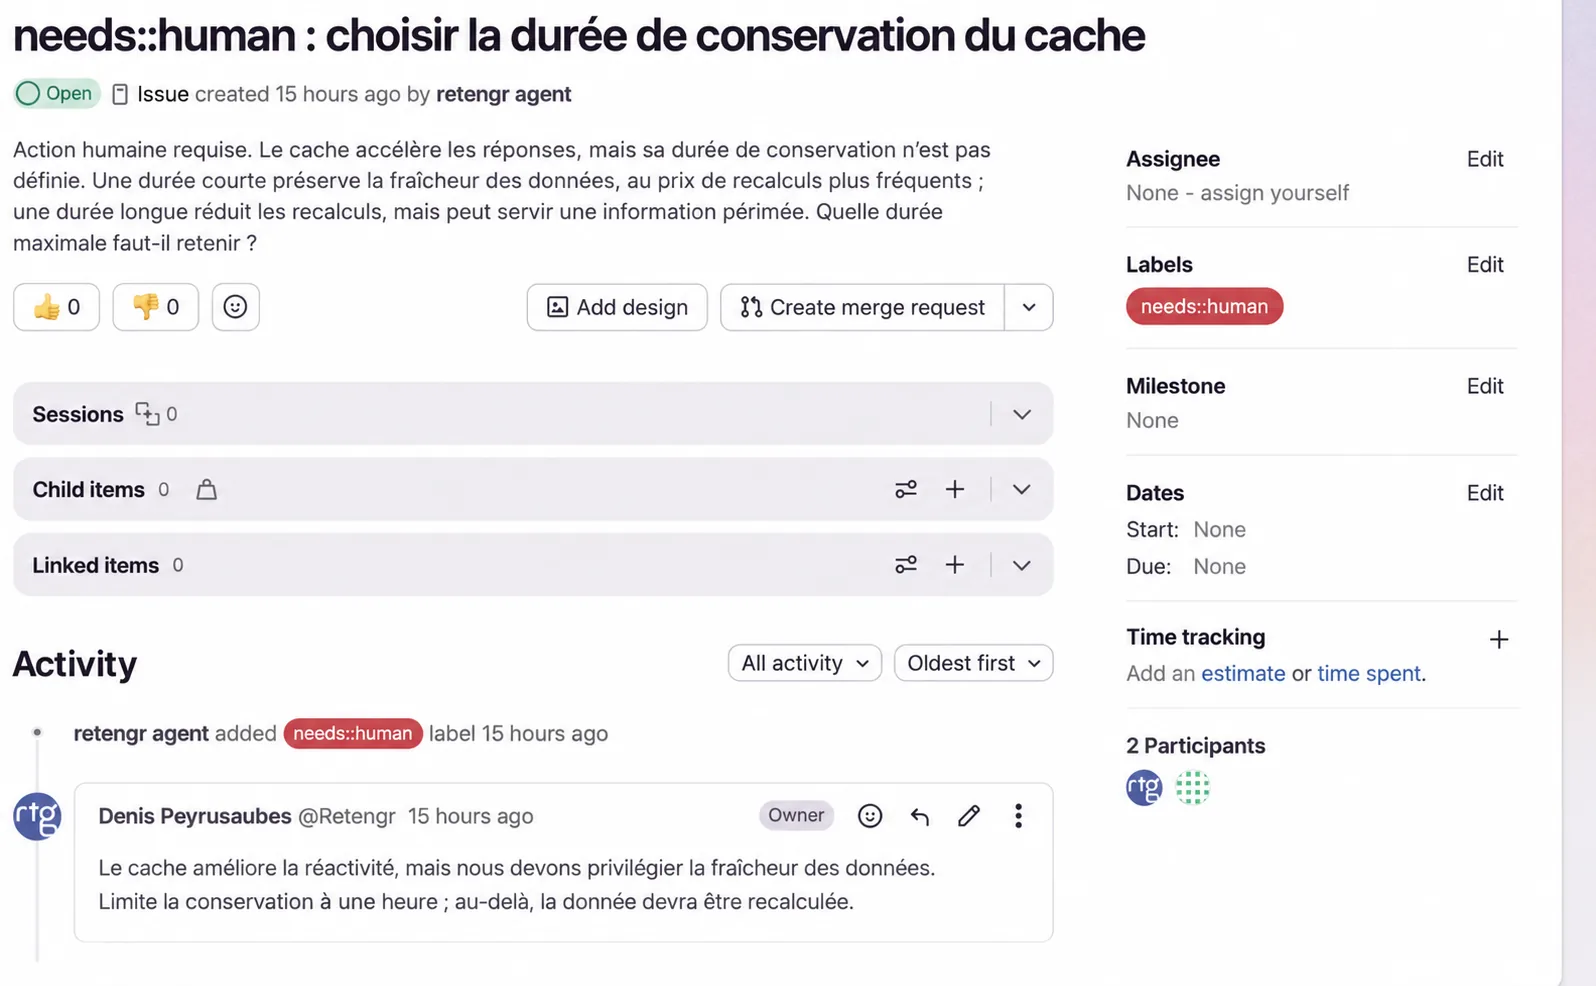
needs::human ; ce signal débloque l’agent et relance le processus de création. Ouvrir la capture ↗Un orchestrateur et sept rôles spécialisés
L’orchestrateur n’écrit pas les livrables. Il lit la file, vérifie les dépendances et délègue à sept rôles : préparation, conception, production, conformité, environnement, test et veille. Tous ne tournent pas à chaque fois ; plusieurs tâches indépendantes peuvent avancer en parallèle.
Un agent qui conçoit, écrit, contrôle et déclare lui-même son travail terminé cumule trop de responsabilités. Ici, le producteur peut modifier un fichier, mais le contrôleur reste en lecture seule. Le testeur exécute un scénario sans corriger le dépôt évalué. L’orchestrateur coordonne sans se substituer au spécialiste.
Dans cette architecture, Claude Code joue le rôle de harnais agentique : il lance les agents, leur donne accès aux outils et applique leurs permissions. Ce choix nous impose toutefois d’utiliser les modèles Claude d’Anthropic. Une évolution fondée sur OpenCode est en cours d’étude afin de rendre le harnais indépendant du modèle, de choisir pour chaque agent le LLM le mieux adapté à son rôle et de tendre vers davantage de souveraineté. OpenCode permet en effet de connecter plusieurs fournisseurs et de configurer un modèle différent par agent.
Un POC pour pousser l’autonomie, sans donner tous les pouvoirs
Cette architecture est un POC : nous voulions tester un niveau d’autonomie élevé, avec sept rôles spécialisés capables d’enchaîner les tâches sans opérateur permanent dans la boucle courante. Les premiers résultats sont très positifs : les agents peuvent se répartir le travail, rendre leurs constats visibles dans GitLab et reprendre après une décision humaine, sans qu’il faille surveiller chaque étape.
Cette autonomie ne repose pas sur une confiance aveugle. Les agents utilisent une identité technique distincte sur GitLab ; ils proposent leur travail sur des branches dédiées, tandis que les branches de référence sont protégées et que les agents ne peuvent pas fusionner leurs changements. Les secrets sont conservés séparément, et la VM ne peut lire que ceux qui lui sont nécessaires.
L’instance EC2 qui héberge les agents n’accepte aucune connexion entrante ; son administration passe par un accès dédié. Son rôle AWS autorise les opérations nécessaires à l’exécution, comme appeler les modèles Claude et lire les paramètres prévus, mais pas créer ou modifier des ressources cloud. Les agents peuvent préparer et vérifier une configuration de déploiement, mais ne peuvent pas lancer eux-mêmes le provisioning de l’infrastructure. Le disque est chiffré et l’accès aux métadonnées de la machine est renforcé.
Ces barrières réduisent le rayon d’action d’une erreur ou d’une mauvaise décision ; elles ne rendent pas le système infaillible. Le POC sert justement à éprouver ensemble l’autonomie, les limites de permission et les points où une décision humaine doit reprendre la main.
GitLab centralise les constats et les décisions
GitLab est l’outil retenu dans cet exemple, pas une dépendance de l’architecture. GitHub, Bitbucket ou une autre forge comparable peuvent jouer le même rôle : offrir un espace partagé où les tâches, les constats et les décisions restent visibles et où le travail peut être repris. Les noms diffèrent — Merge Requests dans GitLab, Pull Requests dans GitHub — mais le principe reste le même.
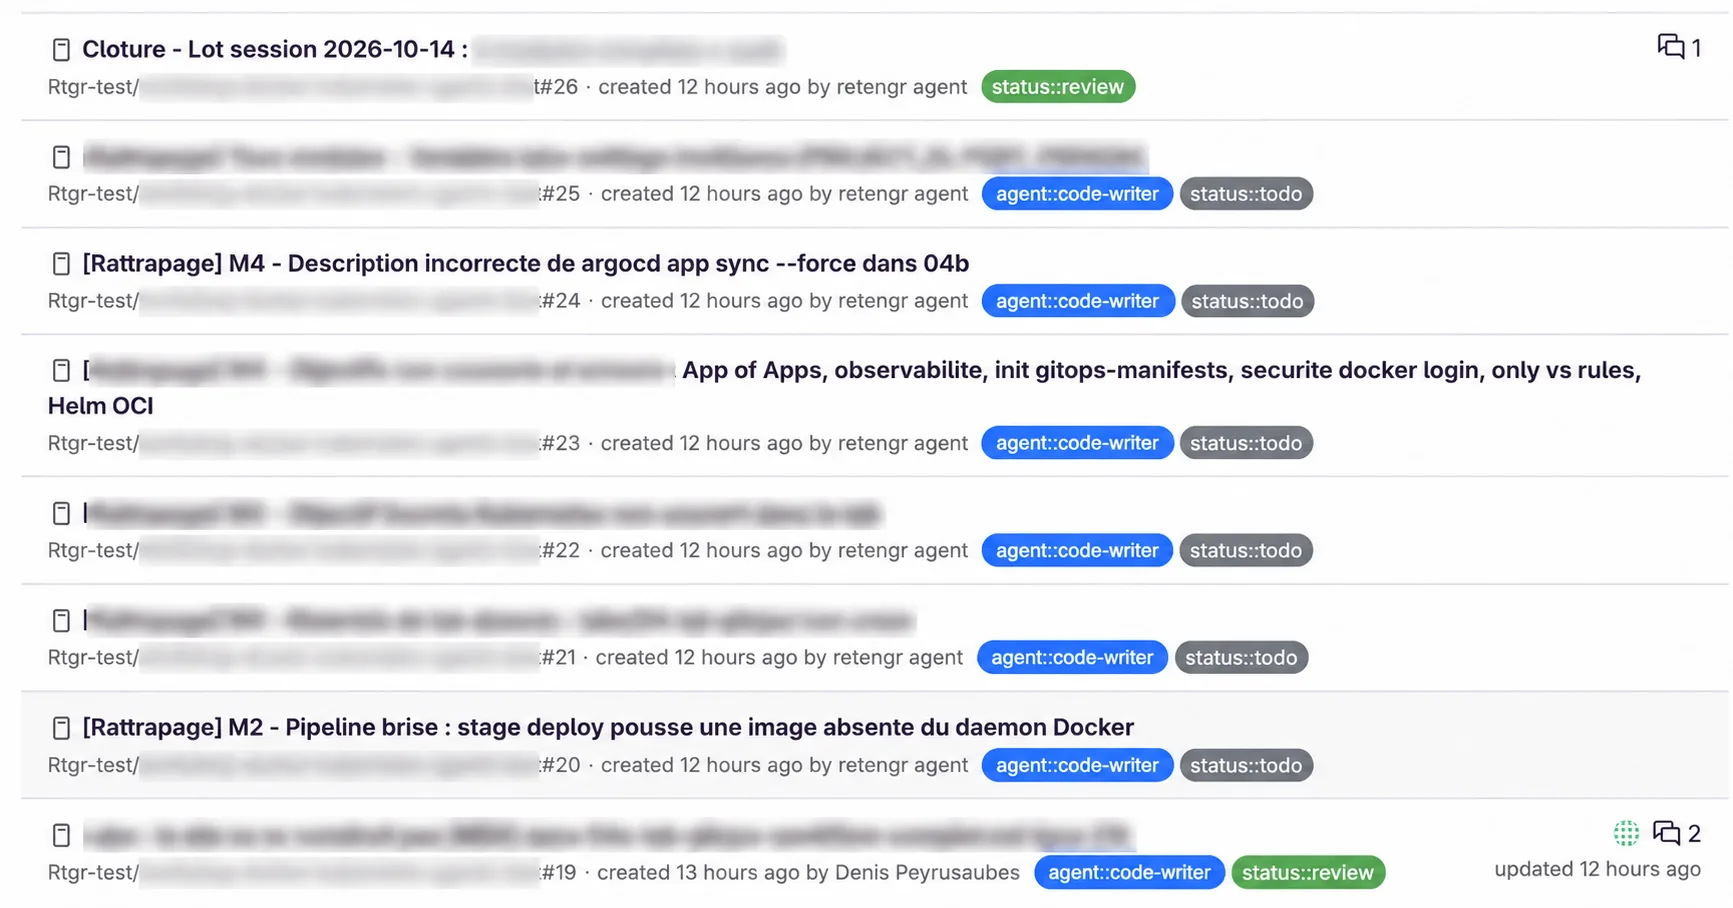
Les agents ne se transmettent pas une conversation privée. Ils se synchronisent par des objets que l’équipe peut relire : issues, labels, commentaires, branches, commits, pipelines et Merge Requests. Une issue peut décrire la tâche initiale ou un écart découvert pendant un contrôle. Ses labels indiquent son état et le rôle qui doit agir. Le commentaire apporte les preuves et la recommandation ; la branche et la Merge Request matérialisent la réponse proposée. Le résultat d’un agent devient ainsi une entrée exploitable par le suivant.
Ces mécanismes rappellent quelques pratiques agiles, sans reproduire Scrum. Les issues forment une sorte de backlog de travail : elles mêlent les demandes initiales et les tâches révélées par les constats des agents, plutôt que de représenter uniquement des exigences planifiées pour un sprint. Les critères de réussite précisent ce qui permettra de fermer une issue ; la Merge Request sert de support à la revue ; le label needs::human rend visible un blocage qui exige une décision humaine.
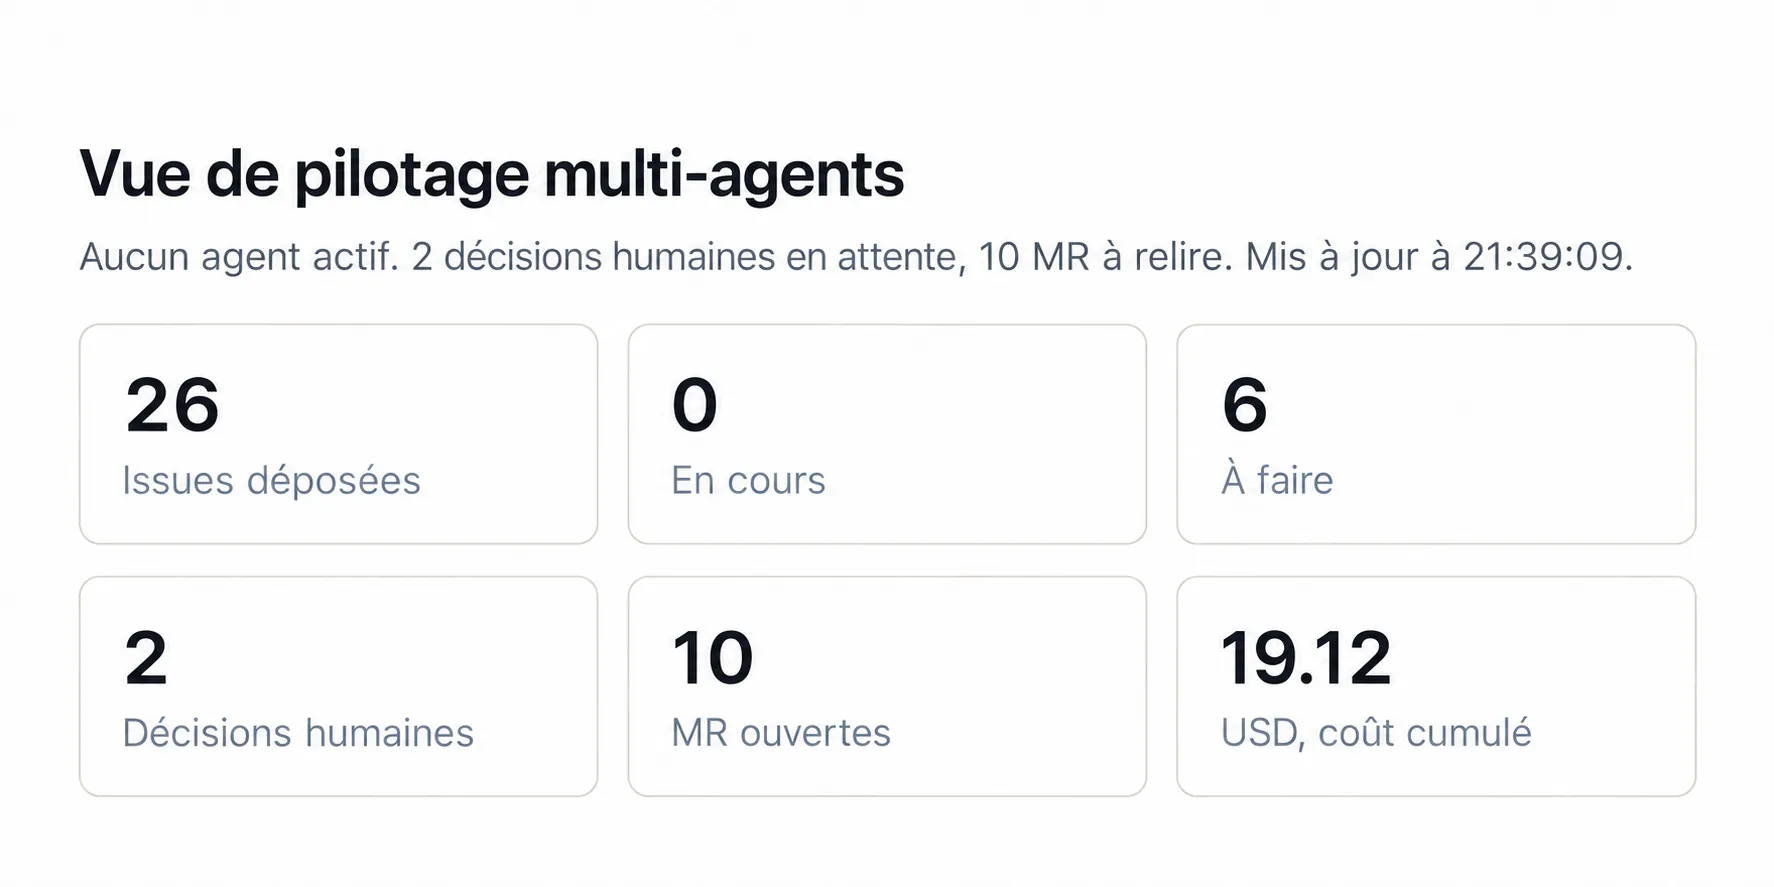
Un dashboard généré automatiquement et mis à jour quasi en direct offre une vue de pilotage au-dessus de GitLab. GitLab reste la source de vérité, tandis que ce tableau rassemble l’état des tâches, les décisions humaines en attente, les Merge Requests, les agents actifs et le coût de leurs tours. L’activité récente précise aussi qui a déposé ou commenté quoi, et pour qui. Sans ouvrir chaque issue une à une, on obtient ainsi une compréhension globale du système de production : pourquoi une tâche existe, quel constat l’a déclenchée et quel agent doit maintenant la prendre en charge.
Ce choix facilite la reprise après incident. Si une VM s’arrête, l’orchestrateur suivant relit GitLab et retrouve l’issue verrouillée, la branche, le rapport et les dépendances ouvertes. L’état critique ne dépend ni de la mémoire du modèle ni d’un processus.
Chaque agent producteur travaille dans son propre worktree Git. Les contrôleurs restent en lecture seule. Aucun agent ne fusionne : les protections de branches GitLab constituent une barrière extérieure au prompt et aux permissions de Claude Code.
Ce rôle de GitLab compte plus que le nombre d’agents. Sans état commun, sept spécialistes deviennent sept conversations à recoller. Avec lui, chacun laisse une preuve exploitable par le suivant.
Deux façons de faire fonctionner Claude Code
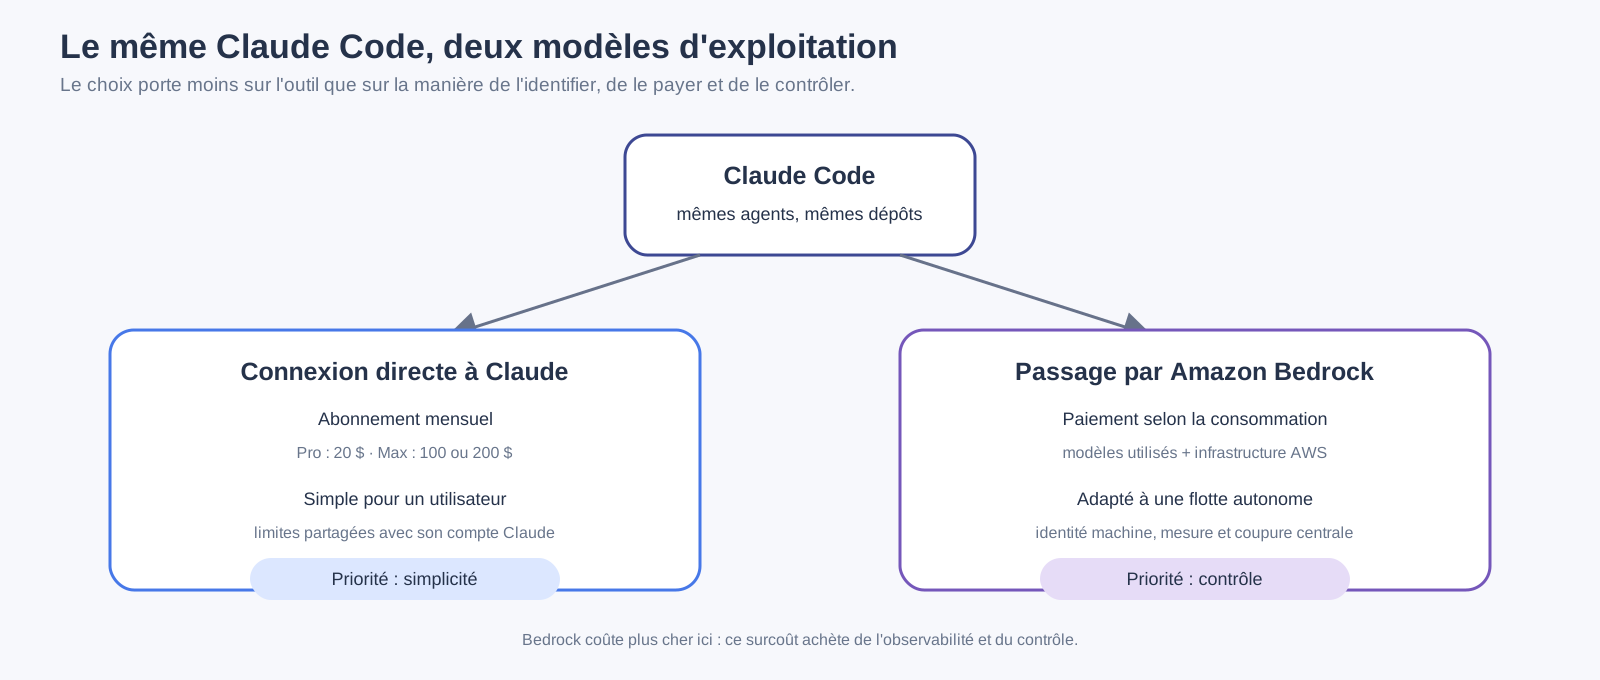
Claude Code peut être relié directement à un compte Claude ou passer par Amazon Bedrock, le service managé d’AWS qui donne accès à des modèles d’IA générative comme Claude. L’outil et les agents restent les mêmes ; ce sont la facturation et le contrôle qui changent. La documentation Claude Code présente ces modes d’authentification.
Le mode natif convient bien à une personne qui travaille dans son terminal. Au 15 octobre 2026, Claude Pro coûte 20 dollars par mois et Claude Max 100 ou 200 dollars selon le niveau choisi. Le budget mensuel est lisible, mais l’usage de Claude Code partage les limites du compte avec les autres usages de Claude. Les tarifs Claude restent à vérifier au moment du choix.
Bedrock convient mieux à un service autonome porté par une infrastructure AWS. Il facture la consommation réelle des modèles, à laquelle s’ajoutent la machine et l’observabilité. La dépense varie donc avec le nombre de tâches et leur longueur : presque rien lorsque les agents sont arrêtés, davantage lors d’un chantier intensif.
Dans cette architecture, Bedrock est plus cher : à la consommation des modèles s’ajoutent la machine et l’observabilité. Ce surcoût est assumé pour obtenir un avantage opérationnel : les agents utilisent une identité de machine, leur consommation devient mesurable et leur accès aux modèles peut être coupé centralement. Le choix oppose la simplicité et le prix d’un abonnement individuel au contrôle d’une flotte autonome. La tarification Bedrock reste la référence selon le modèle et la région.
Le kill switch complète les budgets locaux
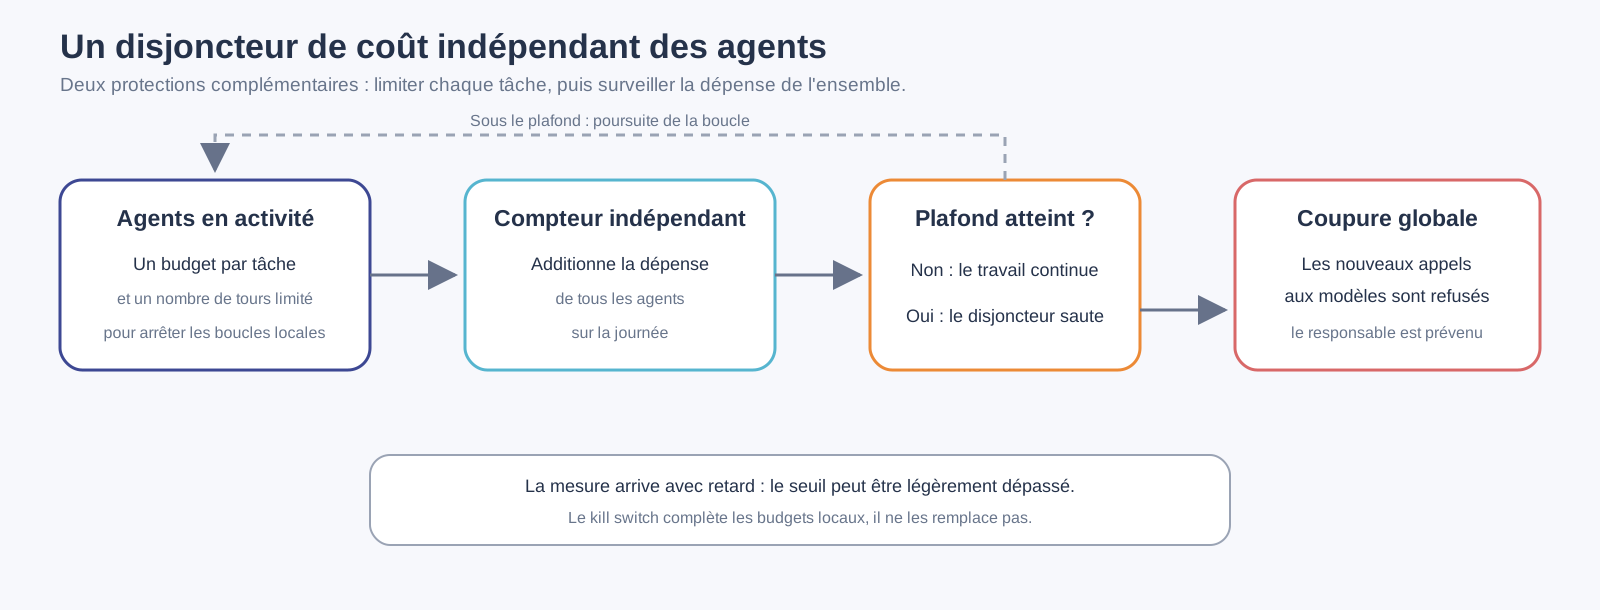
Le contrôle comporte plusieurs étages. Chaque tâche possède d’abord son propre budget et le lanceur limite le nombre de tours simultanés. Ces bornes arrêtent un agent qui boucle, mais elles ne protègent pas contre plusieurs agents qui dépensent en même temps.
Un dernier garde-fou reste donc extérieur à Claude Code. Un compteur indépendant surveille la dépense totale de la journée. Lorsque le plafond est franchi, il coupe l’accès aux modèles pour l’ensemble des agents et prévient le responsable. Aucun prompt ne peut contourner cette coupure, puisqu’elle est appliquée par l’infrastructure qui autorise les appels.
Ce kill switch ressemble davantage à un disjoncteur qu’à un compteur électrique prépayé. Les informations de facturation arrivent avec un délai : une activité rapide peut dépasser légèrement le plafond avant la coupure. Les petits budgets par tâche restent donc indispensables ; le disjoncteur global intervient s’ils ne suffisent pas. AWS documente ce délai dans son guide Budgets.
Dans notre déploiement, ce disjoncteur ciblé est en place. Le test complet du dépassement puis de la coupure reste néanmoins à valider de bout en bout : installer un garde-fou ne suffit pas, il faut encore prouver qu’il arrête réellement les appels.
Ce que cette architecture nous apprend
L’autonomie vient du protocole, pas seulement du modèle. Une issue exploitable, un verrou, une sortie structurée et une condition d’arrêt réduisent davantage les interventions qu’un prompt plus long.
GitLab devient une base de coordination : le dépôt contient les livrables, les issues portent la file, les Merge Requests matérialisent les propositions et les protections de branches imposent les décisions humaines.
Le coût est un risque d’exécution. Les métriques Bedrock, les journaux par tour, les limites locales et le kill switch IAM répondent à des échelles différentes. Aucun ne suffit seul.
Enfin, « sans interaction humaine » doit rester une propriété mesurée. Un système autonome n’est pas celui qui ne pose jamais de question. C’est celui qui sait poursuivre les tâches non bloquées, enregistrer précisément la décision manquante et s’arrêter avant d’improviser.
Pour approfondir l’utilisation du harnais, consultez la formation Maîtriser Claude Code et l’environnement Claude. La conception, les permissions, l’observabilité et l’exploitation de telles chaînes sont abordées dans la formation Agents : mise en production et architectures avancées.